InfoSec, AppSec, ICT Systems Integration, Virtualizzazione, FOSS e dintorni
Categoria: Cybersecurity
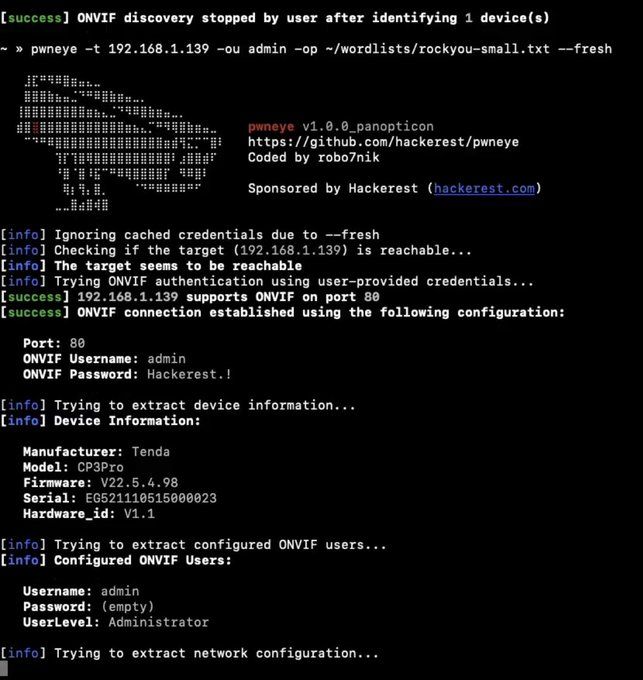
PwnEye è un tool di ethical hacking progettato per operare su telecamere IP (meglio conosciute come webcam) che espongono servizi ONVIF e RTSP; offre ai ricercatori e ai pentester un metodo semplice per gestire l’individuazione, i test di autenticazione, la raccolta di metadati, la convalida dei flussi, la registrazione e le azioni di follow-up richieste da un servizio professionale di offensive security, il tutto attraverso un’unica CLI.
Se l’autenticazione ONVIF sulla webcam ha esito positivo, pwneye consente anche di accedere direttamente a una shell ONVIF interattiva. Questa funzionalità è utile quando si desidera esaminare i servizi esposti, invocarne manualmente i metodi, esplorare le funzionalità o testare operazioni specifiche per il target senza interrompere il flusso corrente di lavoro.
In una webcam una interfaccia webaccattivante non è auotomaticamente sinonimo di apparato sicuro nel suo complesso da vulnerabiltà o attacchi informatici: è frequente riscontrare meccanismi efficaci di blocco per gli accessi via web, mentre il protocollo RTSP è spesso sprovvisto diautenticazione o accetta un numero di tentativi di autenticazione praticamente illimitato.
Se stai per avviare un vulnerability assessment delle webcam, sfrutta la funzionalità rilevamento quando possibile: se l’opzione --discover funziona sulla rete locale, utilizzala per prima. Le informazioni sul vendor, i metadati del dispositivo e i dati recuperati dalla cache possono rendere le successive operazioni RTSP molto più affidabili e silenti.
Se subisci pressioni, vessazioni o un trattamento scorretto – sul lavoro o altrove – c’è una buona abitudine che può tutelarti: registrare e documentare. A una condizione precisa, che rende tutto perfettamente lecito.
La regola di base è semplice: puoi registrare una conversazione se sei tu stesso a parteciparvi. Non serve il preavviso, non serve il consenso dell’altra persona. Registrare un colloquio a cui prendi parte è lecito, perché stai documentando un fatto che ti riguarda in prima persona. È un principio riconosciuto dalla Cassazione, che qualifica le registrazioni effettuate come prova documentale e non come intercettazione. Se un superiore ti vessa, se ricevi minacce, se qualcuno ti tratta in modo scorretto, una registrazione può diventare una prova con valore anche in sede legale. In questi casi documentare è spesso l’unico modo per trasformare la tua parola in qualcosa di verificabile. C’è però un confine netto: non puoi lasciare un dispositivo a registrare i discorsi tra le altre persone quando non sei presente. Quella non è più documentazione: è intercettazione abusiva tra privati, punita dall’art. 617-bis del codice penale. Sul come, una nota pratica. Il registratore del telefono funziona, ma tirare fuori lo smartphone ovviamente segnala a tutti che li stai registrando, e in certe situazioni è controproducente. Esistono piccoli registratori audio dedicati, economici e con buona autonomia, pensati per catturare l’audio in modo semplice ed efficiente. Sono più pratici e affidabili se hai la necessità legittima di documentare ciò che accade nel contesto lavorativo o domestico in cui vivi. In breve: se sei parte della conversazione, hai il diritto di documentarla. Se non lo sei, legalmente non puoi intercettarla. Conoscere questa linea di confine è il modo migliore per tutelarti senza finire, a tua volta, dalla parte del torto.
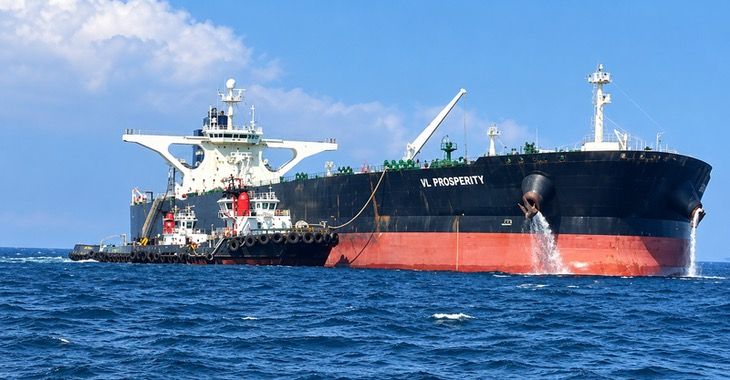
Una gigantesca petroliera che trasportava 2.3 milioni di barili di greggio stava attraversando l’Atlantico, ma da qualche parte vicino a Gibilterra degli hacker sono riusciti a eludere le difese della nave, interferendo con i sistemi di alimentazione e la velocità del motore, mandando in tilt le comunicazioni per circa 30 ore.
Due settimane più tardi, l’FBI e la Guardia Costiera statunitense sono saliti a bordo per far luce sull’accaduto: dalle indagini risulta che sia i sistemi di alimentazione che le impostazioni del motore fossero accessibili tramite servizi connessi a Internet o, quantomeno, non adeguatamente segmentati in questa petroliera compromessada remoto!
L’attacco informatico alla nave VL Prosperity solleva una domanda semplice ma doverosa: come è stato possibile per un attacker passare da una rete protetta dall’esterno tramite firewall ai sistemi critici della nave?
L’accesso iniziale (secondo MITRE ATT&CK fase 1 di qualunque vero attacco informatico strutturato) può avvenire tramite SATCOM, VPN, manutenzioni da remoto o sistemi IT compromessi, tuttavia è proprio lì che l’attacco dovrebbe arrestarsi se nel target sono state anticipatamente implementate difese informatiche effettivamente robuste e ben collaudate. Se i sistemi OT devono solo trasmettere dati sui macchinari, allarmi, informazioni storiche o dati di monitoraggio delle condizioni, non vi è motivo di mantenere un percorso bidirezionale tra la rete OT stessa e la rete ICT (Purdue model docet!). Un sistema OT messo in sicurezza bloccherebbe fisicamente il percorso di ritorno della connessione, impedendo il bypass del firewall, attacchi di tipo credential stuffing via VPN o lo sfruttamento di vulnerabilità. Si tratta semplicemente di una comunicazione unidirezionale garantita da hardware ottico passivo. Quando sono in gioco i sistemi di propulsione, di raffreddamento o i macchinari di una petroliera da 333 metri di lunghezza e 2.3 milioni di barili di capacità, la segmentazione di rete non può basarsi su congetture e piani teorici lasciati al caso: la sicurezza informatica dell’apparato industriale in esame, infatti, dovrebbe essere adeguatamente anche testata tramite specifici vulnerability assessment prima che all’impianto stesso venga consentito di entrare in produzione (in questo caso, alla nave di lasciare la terraferma).
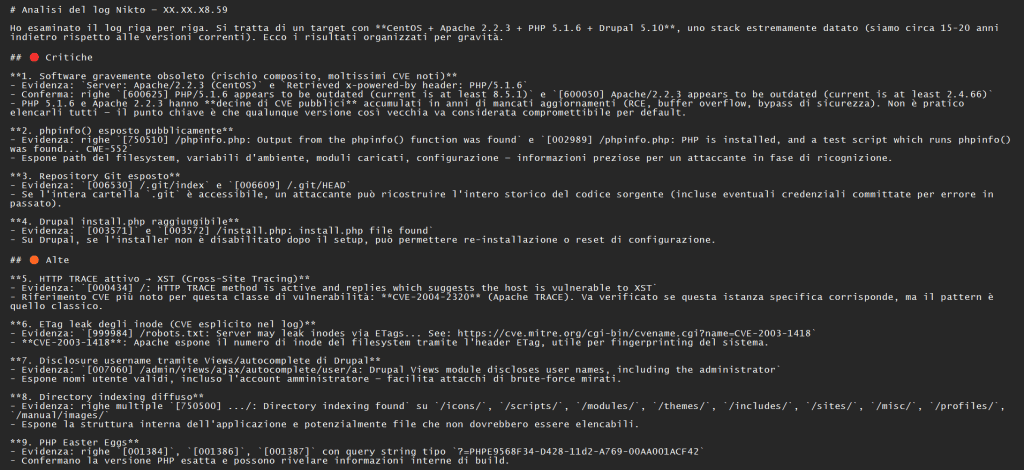
Foto da una sessione di analisi condotta con l’ausilio dell’AI Claude, utilizzata per il parsing e la fase di triage dell’output generato dal tool Nikto durante un vulnerability assessment su di una webapp target di un mio cliente (un software gestionale scritto in PHP).
Come da videata, l’enumerazione delle vulnerabilità mostra una superficie di attacco tutt’altro che trascurabile: misconfigurazioni multiple, header di sicurezza mancanti e potenziali vettori di exploitation a livello applicativo (per motivi di privacy ho oscurato l’IP pubblico associato al dominio corrispondente al sito web del cliente che mi ha commissionato l’assessment).
Ogni evidenza segnalata da Nikto — successivamente validata/contestualizzata tramite l’analisi assistita da Claude — ha trovato conferma in fase di verifica manuale, dandomi la possibilità di riscontrare la reale sfruttabilità delle issue individuate e non un semplice “rumore” di fondo da falsi positivi, come spesso accade con gli scanner automatici. Il tutto è confluito nel report di assessment finale, consegnato al referente del cliente, fino a quel momento non completamente consapevole dell’effettiva cyber(in)security posture della propria infrastruttura web.
Chi ha una solida preparazione in ambito Cybersecurity (reti, sistemi operativi, protocolli, scripting, ethical hacking, un minimo di reverse engineering) possiede alcune competenze tecniche chiave che gli permettono di integrare l’AI nelle proprie analisi:
comprende il perché degli eventi e del loro accadimento, non solo “il cosa”. Sa spiegare perché un pattern di traffico è anomalo, non si limita a leggere un alert. Conosce il TCP/IP abbastanza da capire se uno strano beaconing è DNS tunneling o solo un client mal configurato.
sa validare (o smontare) l’output dell’AI. Se un tool basato su LLM gli comunica “questo è un malware”, sa verificare gli hash, l’entropia del file, il comportamento in sandbox, e giudicare se la conclusione regge.
riconosce i falsi positivi e i falsi negativi con criterio scientifico: non si fida ciecamente di un punteggio di rischio generato automaticamente, ma lo contestualizza.
è in grado di analizzare la situazione anche quando il software in uso non copre il caso: in un incidente informatico reale, spesso i tool non hanno visto “quella” combinazione specifica prima, serve appunto comprendere i sistemi sottostanti per costruire un’ipotesi realistica.
ha intuito per le anomalie sottili: un attacker avanzato come un APT lascia tracce minime e non standard, ma solo chi sa o è davvero in grado di capire come funzionano i sistemi nota quando “qualcosa non torna”.
Viceversa, chi usa l’AI in modalità “bovina”, senza farsi troppe domande:
è in grado di osservare una dashboard, ma spesso di non comprendere realmente cosa c’è sotto. Segue playbook e tool di output senza sapere perché quel passaggio esista.
Non riesce a distinguere un’allucinazione dell’AI da una corretta analisi – gli LLM possono generare spiegazioni plausibili ma sbagliate (per esempio possono attribuire un comportamento benigno a una tecnica MITRE ATT&CK a caso, solo perché “suona giusto”).
È vulnerabile ad evasion mirate. Un attacker consapevole che un certo SOC usa l’AI generativa per il triage potrebbe forgiare attacchi informatici che sfruttano proprio i bias del modello (prompt injection nei log, testo ingannevole nei nomi dei processi, ecc..).
Fatica nell’incident response reale: quando si lavora sotto pressione, dovendo analizzare tanti sistemi compromessi con tempistiche limitate possono venire a mancare le fondamenta per prendere decisioni razionali ma tempestive senza qualcuno che gliele suggerisca oltre all’AI (e se nel frattempo l’analista dovesse terminare i token a sua disposizione?).
Diventa un collo di bottiglia, non un facilitatore: l’AI dovrebbe agevolare chi sa già cosa cercare, ma senza solide basi, un analista SOC semplicemente sposta la fiducia dall’esperienza umana al modello LLM, con un netto peggioramento in termini di affidabilità delle analisi stesse.
L’AI adottata nel campo della sicurezza informatica dovrebbe fungere da agevolatore di competenze, non da sostituto di formazione indispensabilmente pregressa. Un analista SOC che si rispetti dovrebbe usare l’AI con la dovuta consapevolezza per: – ridurre il rumore (triage di migliaia di alert) – accelerare la correlazione tra eventi – generare ipotesi da verificare con celerità.
Senza solide basi tecnico-scientifiche, l’AI diventa solo una sorta di scatola magica a cui si delegano in maniera temeraria le analisi — ma delegare un giudizio critico è sempre pericoloso: gli attacker sono avversari attivi che si adattano, non un problema statico che un LLM può risolvere una volta per tutte.
In sintesi: la differenza non è tanto tra “chi usa l’AI e chi no”, ma tra chi sa quandofidarsi di un’AI e quando no — e questo si apprende solo con l’esperienza e con una doverosa formazionecontinua (passata, presente e futura).
Di recente è stata rilasciata la versione 4.0.2 di OpenSSL (la 3.5.8 se si utilizza la versione LTS), che corregge diverse vulnerabilità di sicurezza informatica.
Potresti impiegare una vita cercando disperatamente di capire se il tuo codice può effettivamente beneficiare degli aggiornamenti, ma se hai il controllo completo della tua build di OpenSSL ed escludi tutto ciò che non ti serve realmente (un’operazione che, a onor del vero, spesso richiede un effort maggiore di quanto molti siano disposti a dedicarvi), potresti riuscirci con una certa tempestività. In alternativa, puoi semplicemente scaricare e ricompilare il codice con la nuova versione.
Nessun bug è stato classificato con una gravità superiore a “Moderato”, ma è stata risolta almeno una vulnerabilità interessante dal punto di vista dei bias crittografici: due cifrariAEAD (in altre parole, un algoritmo crittografico con autenticazione a chiave integrata tramite un hash calcolato in parallelo con la crittografia/decrittografia) “approvavano” sempre un testo cifrato vuoto durante la decifratura, anche se veniva inviato un hash di autenticazione errato!
Potrebbe non essere facile da sfruttare, ma se effettivamente accadesse, questa vulnerabilità consentirebbe a un malintenzionato di fornire un falso buffer in input per la decifratura, che potrebbe ingannare il test AEAD. Ricordiamoci anche che una stringa vuota ha un solo hash AEAD valido per ogni chiave: “nothing” è spesso un input valido, e in fase di decifratura dovrebbe essere soggetto al medesimo livello di validazione di qualsiasi altra stringa in chiaro!
L’hacking satellitare e la sicurezza informatica aerospaziale non sono più appannaggio esclusivo delle aziende specializzate.
Durante la 26° edizione del Defcon sarà presentato il primo CubeSat open-source intenzionalmente vulnerabile (PWNCUBE), creato specificamente per le comunità scientifiche e per appassionati al fine di poter apprendere, fare ricerca e spingere oltre i confini della sicurezza informatica aerospaziale utilizzando una piattaforma estremamente pratica.
Un ambiente aperto e pratico progettato per analizzare, sfruttare vulnerabilità e comprendere come proteggere in modo sicuro i sistemi aerospaziali.
Cosa include: – GNU/Linux come sistema di navigazione e controllo – Ground Station: supporto per stazioni di terra, test di comunicazione terra-satellite in tempo reale – Collegamenti e comunicazioni radio – Supporto GPS: pronto per attività di spoofing, jamming e ricerca sul posizionamento – emulatore SpaceCAN: simulazione completa dei bus di comunicazione per voli spaziali – implementazione di SSP e CCSDS: protocolli standard di settore integrati per una ricerca approfondita – 34 vulnerabilità integrate: distribuite su vari componenti del sistema, pronte per essere scovate e sfruttate
Se la sicurezza satellitare, la sicurezza informatica dei sistemi embedded e/o dei protocolli di comunicazione aerospaziale ti appassionano o sono parte del tuo lavoro, PWNCUBE è uno strumento ideale per fare pratica con un ambiente simulato ma altamente realistico.
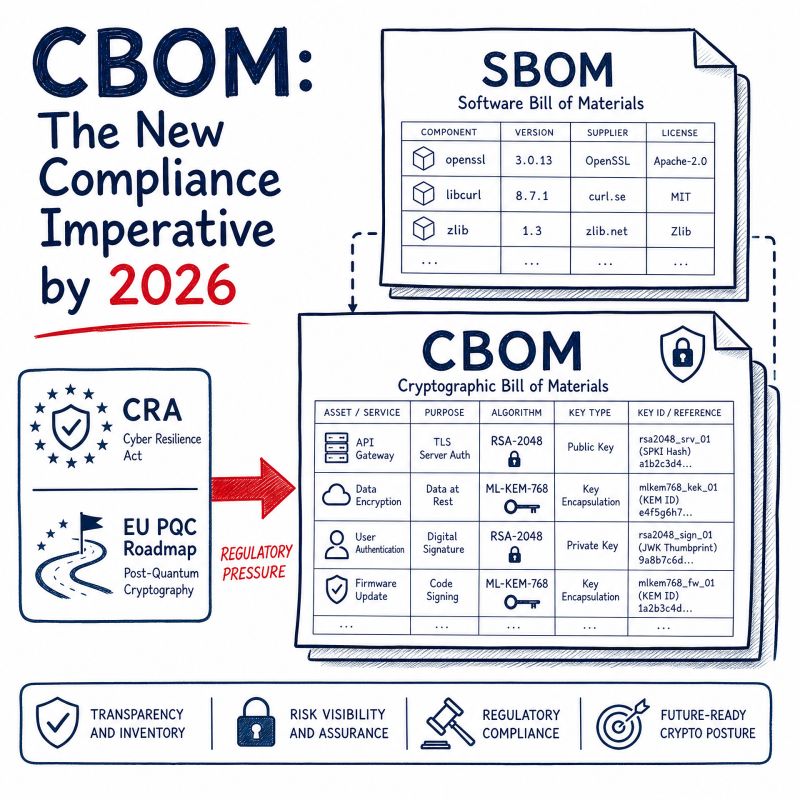
Mentre la maggior parte delle organizzazioni gestisce già una distinta base del software (SBOM), la distinta base crittografica (CBOM) rimane in gran parte trascurata. Eppure le normative UE 🇪🇺 stanno convergendo rapidamente per rendere l’inventario crittografico un requisito obbligatorio.
Il Cyber Resilience Act (CRA) e la direttiva europea NIS2 insieme alla roadmap PQC dell’UE, stanno creando un chiaro mandato per la trasparenza crittografica: entro la fine del 2026, comprendere e gestire le proprie risorse crittografiche non sarà più facoltativo, passando da una questione di nicchia a un pilastro fondamentale per la conformità 🇪🇺.
💡PERCHÉ DOVREBBE INTERESSARTI (se produci e/o vendi software o dispositivi ICT/IoT/OT) ↳ Può aiutarti ad evitaresignificative sanzioni per non conformità e/o ad evitare restrizioni per l’accesso al mercato europeo ai sensi delle nuove normative UE 🇪🇺.
↳ Può essere utile per individuare anticipatamente eventuali vulnerabilità critiche derivanti da implementazioni crittografiche non gestite oppure obsolete, soprattutto con l’avvento del passaggio obbligato alla crittografia post-quantum (PQC).
↳ Fondamentale per prepararsi a revisioni operative nello sviluppo dei propri prodotti (software e/o hardware), nella gestione delle catene di fornitura (supply chain security) e per la risposta agli incidenti, che richiederanno nuovi strumenti e competenze.
💡AZIONI CONCRETE —> occorre condurre periodicamente audit completi di tutti i componenti crittografici presenti nei dispositivi, software e sistemi digitali —> sviluppare una solida strategia di generazione e gestione del CBOM (Cryptographic Bill Of Materials), integrandola nei framework di conformità esistenti. —> investire in formazione e strumenti per garantire che i team possano identificare, tracciare e aggiornare efficacemente le risorse crittografiche.
💡STANDARD e REGOLAMENTI di riferimento 🇪🇺 Questo cambiamento è promosso direttamente dal Cyber Resilience Act (CRA), dalla direttiva NIS2 e dalla roadmap PQC dell’UE, rendendo l’inventario crittografico un aspetto fondamentale per la conformità alla sicurezza informatica.
Se nell’azienda in cui lavori sviluppate, certificate o vendete prodotti digitali destinati al mercato europeo 🇪🇺, l’inventario crittografico deve diventare parte attiva del vostro standard di riferimento per la sicurezza informatica e la conformità.
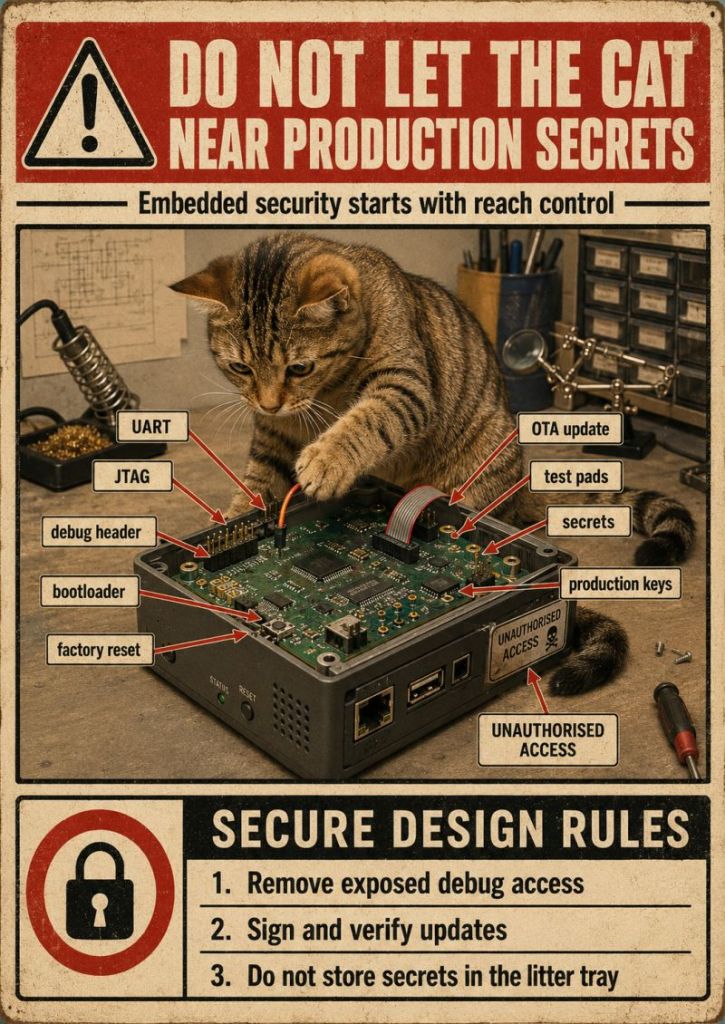
Da decenni i gatti sono un simbolo della sottocultura hacker per diversi motivi:
I meme con i gatti dominano Internet fin dai primi anni 2000. Meme come Lolcats, Nyan Cat, Grumpy Cat ecc. sono stati in parte diffusi proprio dalle prime community tech e hacker, veri primi utenti virali ma liberi di Internet.
Il trolling e l’ironia: gli hacker (specialmente quelli legati ad Anonymous e a community come 4chan) amano l’ironia e seguire la loro curiosità. Chi usa immagini di gattini simpatici in contesti seri o intimidatori lo fa per creare deliberatamente un contrasto satirico — una sorta di trolling culturale.
Nascondere qualcosa di inaspettato o incasinante (come un gatto ad esempio) dentro qualcosa di serio, nella sottocultura hacker rappresenta un classico scherzo. È il principio del bait and switch.
Anonymous e i gatti: storicamente il gruppo di hacktivistiAnonymous ha usato immagini contenenti dei gatti nei propri messaggi, spesso per deridere l’incompetenza tecnica delle vittime di attacchi informatici, o come firma ironica.
Simbolo di indipendenza: a differenza dei cani (Ivan Pavlov docet!), i gatti sono animali imprevedibili, non particolarmente adatti per essere ammaestrati — caratteristiche con cui molti hacker si identificano spiritualmente.
In sostanza, sebbene dietro il rapporto tra gatti e hacker non ci sia una reale motivazione tecnico-scientifica, i gatti sono diventati de facto la mascotte non ufficiale della creatività fuori dagli schemi, e gli hacker li hanno virtualmente adottati con entusiasmo e autoironia. Il poliedrico matematico nonché creatore di rompicapi RaymondSmullyan ad esempio, era un appassionato di gatti in modo quasi ossessivo, e i felini compaiono in molte delle sue opere in vari enigmi come elementi narrativi dei paradossi. Leggendo i libri di Smullyan si intuisce subito che per lui i gatti rappresentavano creature un po’ anarchiche che vivono al di fuori delle regole e/o delle certezze imposte — esattamente come l’ideale di molti hacker.
Un hacker che metta un gatto in un sistema compromesso sta dicendo, inconsciamente o meno, la stessa cosa che prova a trasmetterci Smullyan nei suoi testi e con le sue dimostrazioni di logica formale: “le regole sono costruzioni umane arbitrarie, ma io — come un gatto — posso provare a sovvertirle se trovo la chave giusta per aggirarle con un approccio creativo fuori dai soliti schemi”.
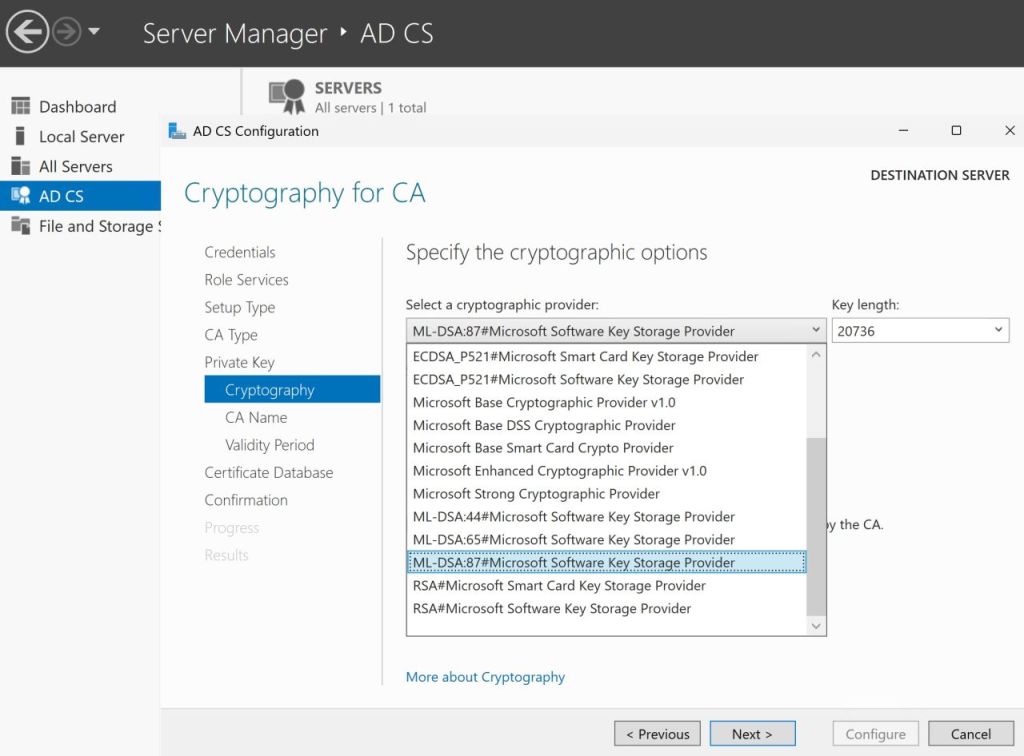
Microsoft ha appena rilasciato il primo vero aggiornamento che include crittografia PQC (Post-Quantum Cryptography) per Active Directory CS (Certificate Services).
Windows Server 2025 d’ora in avanti supporta gli algoritmi ML-DSA in Active Directory CS (KB5087539), inclusi i modelli di certificati digitali PQC e il supporto per la loro registrazione.
Un passo importante verso l’integrazione della crittografia PQC nell’ecosistema PKI di Microsoft.
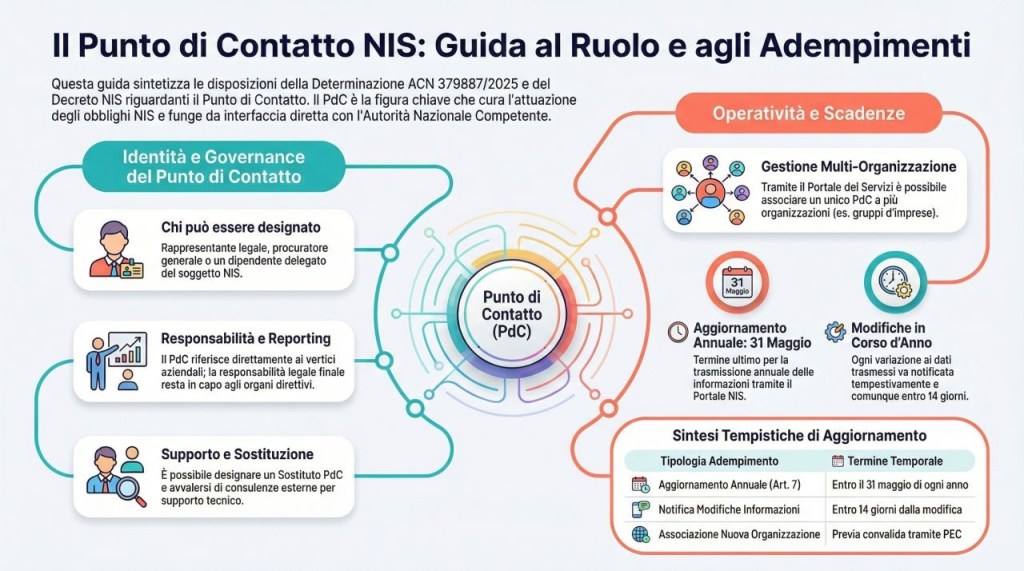
Se si chiama “punto di contatto” deve essere reperibile… o no?!? E invece, per la governance NIS2 il ruolo è affidato spesso a figure apicali, che per mille motivi non possono garantire quella reperibilità (e talvolta neanche quella necessaria competenza tecnica) doverosa per segnalare tempestivamente un incidente informatico.
Legali rappresentanti o manager che sono spesso in trasferta, ad eventi di networking o che ancor peggio non presidiano operativamente i sistemiICT.
E in uno scenario di emergenza, tutto questo può avere gravi conseguenze.
Il punto di contatto non dovrebbe essere visto come un ruolo di rappresentanza: è infatti una funzione operativa chiamata a “curare” l’attuazione degli adempimenti NIS2!
🔹E se il S.O.C. chiamasse alle 2 di notte? 🔹E se il referente CSIRT (magari esterno) avesse necessità di un confronto? 🔹E se venisse inserito come figura attiva nelle procedure di Incident Response?
L’anno scorso, mossi anche da una certa fretta, sono state fatte alcune scelte sul portale ACN, ma adesso e fino al 31 maggio è possibile aggiornare anche questi dati!
👉 La governance può diventare proprio un elemento di aggiornamento, anche alla luce delle procedure di Incident Response che devono essere implementate con estrema attenzione.